从 .onnx 到"把水递给我":具身智能完整技术栈深度解析
一个 .onnx 文件能让机器人走路、踢球、跳舞。但要让机器人"把桌上的水杯递给你",.onnx 只是冰山一角。这篇文章从最底层的控制策略出发,逐步拆解具身智能的完整技术链路。
一、.onnx 是什么
ONNX,全称 Open Neural Network Exchange(开放神经网络交换格式),是 AI 模型领域的"PDF"。
不管你用 PyTorch 还是 TensorFlow 训练的模型,都能导出成 .onnx 格式,然后用任何编程语言、在任何硬件平台上加载运行。它的核心价值是**"一次训练,到处部署"**。
一个 .onnx 文件内部包含三样东西:
- 计算图:神经网络的结构,输入多少维、输出多少维、中间经过哪些层
- 权重参数:训练好的浮点数,是模型的"知识"
- 元数据:输入输出的名称、数据类型等描述信息
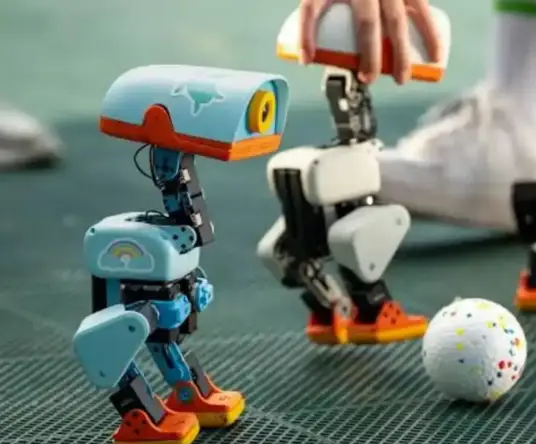
以 MicroDuck 机器人为例,一个走路策略的 .onnx 文件只有几百 KB 到几 MB,内部结构是:
text
输入:61 维观测向量(关节角度、角速度、重力方向、相位信号等)
隐藏层:512 → 256 → 128 个神经元,ELU 激活函数
输出:15 维关节角度指令(对应 15 个舵机)
输入:61 维观测向量(关节角度、角速度、重力方向、相位信号等)
隐藏层:512 → 256 → 128 个神经元,ELU 激活函数
输出:15 维关节角度指令(对应 15 个舵机)
这个模型每 20 毫秒推理一次,输入当前传感器数据,输出下一步每个关节应该转到什么角度。它就是机器人的**"小脑"**——不懂语言,不懂视觉,但能让身体动起来。
二、一个 .onnx 文件等于一个技能
具身智能系统的设计原则是:一个 .onnx 文件对应一个独立的技能。
MicroDuck 机器人的技能库如下:
| 类别 | 技能 | 文件 |
|---|---|---|
| 基础运动 | 站立 | alpha_stand.onnx |
| 基础运动 | 行走 | alpha_walking.onnx |
| 基础运动 | 坐下起立 | alpha_sitstand.onnx |
| 灵巧操作 | 左脚踢球 | ball_kick_left.onnx |
| 灵巧操作 | 右脚踢球 | ball_kick_right.onnx |
| 灵巧操作 | 弯腰捡东西 | alpha_ground_pick.onnx |
| 特技动作 | 翻滚 | roller.onnx |
| 特技动作 | 蹲姿翻滚 | roller_crouch.onnx |
| 特技动作 | 侧翻 | roulade.onnx |
| 复合编排 | 舞蹈 | 多段动作组合(摇摆+旋转+蹲下+点头,12秒循环) |
为什么不让一个 .onnx 文件学会所有动作?原因有三个:
- 1.单技能策略更简单,学得更好、更稳定。把走路和踢球混在一起训练,两个动作都学不好。
- 2.运行时可以灵活切换。用户说"踢球"就加载踢球策略,说"走路"就加载走路策略。
- 3.每个策略文件很小(几百 KB),加载时间可以忽略不计。
python
# 运行时的切换逻辑
if command == "walk":
    policy = load_onnx("policies/alpha_walking.onnx")
elif command == "kick":
    policy = load_onnx("policies/ball_kick_left.onnx")
elif command == "dance":
    policy = load_onnx("policies/dance.onnx")

# 每 20ms 推理一次
while running:
    obs = get_sensor_data()       # 61 维观测
    action = policy.infer(obs)    # 15 维关节角度
    send_to_motors(action)
# 运行时的切换逻辑
if command == "walk":
    policy = load_onnx("policies/alpha_walking.onnx")
elif command == "kick":
    policy = load_onnx("policies/ball_kick_left.onnx")
elif command == "dance":
    policy = load_onnx("policies/dance.onnx")

# 每 20ms 推理一次
while running:
    obs = get_sensor_data()       # 61 维观测
    action = policy.infer(obs)    # 15 维关节角度
    send_to_motors(action)
三、.onnx 策略怎么训练出来
.onnx 策略不是手写出来的,而是在仿真环境中通过**强化学习(RL)**训练出来的。
以"踢球"为例,完整的训练流程如下:
第一步:搭建仿真环境
在 MuJoCo 物理引擎中加载机器人的 URDF 模型和足球模型,定义好物理参数(重力、摩擦力、碰撞检测等)。
第二步:定义奖励函数
这是训练的灵魂。踢球任务的奖励函数包括:
| 奖励项 | 权重 | 说明 |
|---|---|---|
| 追踪到球 | +3.0 | 距离越近奖励越高 |
| 踢球力度方向 | +4.0 | 踢球的力度和方向对不对 |
| 保持直立 | +2.0 | 踢球过程中有没有摔倒 |
| 动作平滑 | -0.5 | 惩罚关节抖动 |
| 脚掌踏平 | -2.0 | 惩罚脚掌离地 |
第三步:强化学习训练
使用 **PPO(近端策略优化)**算法,同时运行 4096 个并行仿真环境,让机器人在每个环境中反复尝试踢球。经过大约 10000 轮迭代(几分钟到几小时),策略逐渐学会踢球。
text
训练过程中的关键指标:
  Episode_Reward → 整体上升(策略在学习)
  Episode_Length → 逐渐增加(摔倒次数减少)
  Loss → 逐渐下降并稳定(模型在收敛)
训练过程中的关键指标:
  Episode_Reward → 整体上升(策略在学习)
  Episode_Length → 逐渐增加(摔倒次数减少)
  Loss → 逐渐下降并稳定(模型在收敛)
第四步:导出 .onnx
python
import torch
model = PolicyModel()
model.load_state_dict(torch.load("checkpoint.pth"))
model.eval()

dummy_input = torch.randn(1, 61)
torch.onnx.export(model, dummy_input, "ball_kick.onnx")
import torch
model = PolicyModel()
model.load_state_dict(torch.load("checkpoint.pth"))
model.eval()

dummy_input = torch.randn(1, 61)
torch.onnx.export(model, dummy_input, "ball_kick.onnx")
第五步:部署到真实机器人
rust
// Rust 中加载 ONNX 模型
let model = ort::Session::builder()?
    .commit_from_file("policies/ball_kick_left.onnx")?;

loop {
    let obs = get_observation();  // 61 维输入
    let output = model.run(inputs![obs]?)?;
    send_to_motors(output);       // 15 维关节角度
    sleep(Duration::from_millis(20));  // 50Hz
}
// Rust 中加载 ONNX 模型
let model = ort::Session::builder()?
    .commit_from_file("policies/ball_kick_left.onnx")?;

loop {
    let obs = get_observation();  // 61 维输入
    let output = model.run(inputs![obs]?)?;
    send_to_motors(output);       // 15 维关节角度
    sleep(Duration::from_millis(20));  // 50Hz
}
四、域随机化:让策略从仿真迁移到真实世界
仿真和现实永远有差异。真实世界的摩擦力、电机响应、传感器噪声都和仿真不一样。如果直接把仿真中训练的策略搬到真实机器人上,效果往往会变差,甚至直接摔倒。
解决这个问题的核心技术叫做域随机化(Domain Randomization)。在训练过程中,每次重置环境时随机改变物理参数:
| 随机化项 | 范围 | 模拟什么 |
|---|---|---|
| 质心位置偏移 | ±3mm | 加工误差 |
| 质量惯性变化 | ±5% | 负载变化 |
| 关节摩擦力变化 | ±10% | 磨损 |
| 电机转子惯量变化 | ±10% | 个体差异 |
| 随机推力 | ±0.2 m/s | 被撞 |
| IMU 安装偏差 | ±6° | 传感器安装误差 |
| 编码器零偏 | ±0.015 rad | 传感器漂移 |
策略在各种"恶劣条件"下都能学会踢球,到了真实机器人上反而觉得"条件还不错",就能正常工作了。这就是 sim-to-real 迁移的核心思想。
为了让训练更高效,还会使用课程学习(Curriculum):先在简单条件下训练,逐步增加难度。比如质心随机化范围从 ±3mm 逐步增加到 ±10mm,让策略有一个循序渐进的学习过程。
五、完整的技能库:按复杂度分层
以当前主流人形机器人为例,.onnx 策略模型训练的动作可以按复杂度分为四个层级。
第一层:基础运动(所有机器人都必须有)
| 动作 | 说明 |
|---|---|
| 站立/平衡 | 保持平衡,抵抗外力干扰 |
| 行走 | 前后左右移动 |
| 跑步 | 速度更快的行走策略 |
| 后退/侧移 | 各方向移动能力 |
| 左转/右转 | 改变朝向 |
| 坐下/起立 | 姿态切换 |
这些是机器人的**"生存技能"**,不会这些连站都站不稳。
第二层:姿态控制(根据任务需求选配)
蹲下、前倾后仰、左右摇摆、点头、摇头。
第三层:灵巧操作(高级能力)
从地上捡起物体、放下物体、推/拉物体、搬运物体、递给对方、接住抛来的物体、踢球。
这些需要手、脚、头等多部位的精确协调。
第四层:特技和恢复(展示和鲁棒性)
前翻滚、后空翻、侧翻、摔倒后恢复站立、绊倒恢复、被推后的恢复、舞蹈(多段动作编排)、跨越障碍、上下楼梯。
恢复类动作尤其重要——真实世界中机器人一定会摔倒、被撞、被绊,如果没有恢复能力,摔倒一次就报废了。
六、.onnx 策略的局限性
现在我们来回答一个关键问题:.onnx 策略能让机器人"把桌上的水杯递给你"吗?
答案是:完全不能。
.onnx 策略模型的能力边界非常清晰:
- ❌ 听不懂语言。"把水递给我"这句话对它来说只是一串无意义的信号。
- ❌ 看不懂世界。摄像头画面对它来说只是一堆数字。
- ❌ 不会推理。它不会想"先走过去,再伸手,再抓住,再拿起来"。
- ❌ 不会处理意外。杯子被移走了怎么办?手滑了怎么办?完全没有应对能力。
一句话总结:.onnx 策略是机器人的"肌肉",不是"大脑"。它能让身体动起来,但没有方向感和目的性。
七、完整的技术栈:六层架构
要让机器人完成"把水递给你"这样的复杂任务,需要一个六层的技术栈协同工作。每一层解决一个特定的问题,缺一不可。
text
┌─────────────────────────────────────────────────┐
│  第 1 层:语言理解(LLM / 多模态大模型)            │
│  "把水递给我" → 理解意图 → 拆解子任务               │
├─────────────────────────────────────────────────┤
│  第 2 层:视觉感知(VLM / 视觉编码器)              │
│  摄像头画面 → 识别物体、估计位姿、理解场景           │
├─────────────────────────────────────────────────┤
│  第 3 层:任务规划(LLM / PDDL 规划器)             │
│  意图 + 场景 → 有序子任务序列                       │
├─────────────────────────────────────────────────┤
│  第 4 层:运动规划(IK / VLA / MoveIt)             │
│  子任务目标 → 关节角度轨迹序列                      │
├─────────────────────────────────────────────────┤
│  第 5 层:底层控制(.onnx 策略 / PID)              │
│  目标角度 + 传感器 → 电机转矩(50-1000Hz)          │
├─────────────────────────────────────────────────┤
│  第 6 层:安全兜底(硬件级限制)                     │
│  力矩限制 / 碰撞检测 / 温度保护 / 紧急停止           │
└─────────────────────────────────────────────────┘
┌─────────────────────────────────────────────────┐
│  第 1 层:语言理解(LLM / 多模态大模型)            │
│  "把水递给我" → 理解意图 → 拆解子任务               │
├─────────────────────────────────────────────────┤
│  第 2 层:视觉感知(VLM / 视觉编码器)              │
│  摄像头画面 → 识别物体、估计位姿、理解场景           │
├─────────────────────────────────────────────────┤
│  第 3 层:任务规划(LLM / PDDL 规划器)             │
│  意图 + 场景 → 有序子任务序列                       │
├─────────────────────────────────────────────────┤
│  第 4 层:运动规划(IK / VLA / MoveIt)             │
│  子任务目标 → 关节角度轨迹序列                      │
├─────────────────────────────────────────────────┤
│  第 5 层:底层控制(.onnx 策略 / PID)              │
│  目标角度 + 传感器 → 电机转矩(50-1000Hz)          │
├─────────────────────────────────────────────────┤
│  第 6 层:安全兜底(硬件级限制)                     │
│  力矩限制 / 碰撞检测 / 温度保护 / 紧急停止           │
└─────────────────────────────────────────────────┘
第 1 层:语言理解——听懂你在说什么
职责:把自然语言转化为结构化的任务描述。
输入:"把水递给我"
输出:
json
{
  "action": "hand_over",
  "object": "water_cup",
  "source": "桌上",
  "target": "用户面前",
  "constraints": ["不洒水", "不捏碎", "等用户接住再松手"]
}
{
  "action": "hand_over",
  "object": "water_cup",
  "source": "桌上",
  "target": "用户面前",
  "constraints": ["不洒水", "不捏碎", "等用户接住再松手"]
}
使用技术:大语言模型(GPT-4、Claude、LLaMA 等)。
为什么需要 LLM? 因为自然语言充满了隐含信息。"递"不是"扔"、不是"倒"、不是"放桌上",而是"拿着送到手边"。"水"是液体,不能洒。这些常识推理只有大语言模型能做到。
部署:云端或边缘服务器,每秒 1-2 次。
第 2 层:视觉感知——看懂周围的世界
职责:分析摄像头画面,输出场景的三维结构信息。
输入:摄像头图像
输出:
text
水杯:
  位置:(x=0.42, y=0.15, z=0.08) 相对机器人基座
  倾斜:5°
  直径:7cm,高 12cm
  材质:光滑塑料
  有水:是(液面 60%)
  建议抓取力:2-3N

用户:
  位置:(x=-0.3, y=0.0, z=1.2)
  面朝:机器人方向
  手伸出:是(准备接杯子)
水杯:
  位置:(x=0.42, y=0.15, z=0.08) 相对机器人基座
  倾斜:5°
  直径:7cm,高 12cm
  材质:光滑塑料
  有水:是(液面 60%)
  建议抓取力:2-3N

用户:
  位置:(x=-0.3, y=0.0, z=1.2)
  面朝:机器人方向
  手伸出:是(准备接杯子)
使用技术:DINOv2(视觉特征提取)、SAM(实例分割)、CLIP(视觉-语言对齐)、深度估计网络。
核心难点:摄像头是 2D 的,但世界是 3D 的。光线变化、遮挡、透明物体(水杯里的水)都会增加难度。
部署:边缘 GPU(Jetson Orin),每秒 10-30 次。
第 3 层:任务规划——先做什么再做什么
职责:把一个大任务拆解成有序的小步骤。
"递水"拆解为 9 个子任务:
| 步骤 | 子任务 | 说明 |
|---|---|---|
| 1 | navigate | 走到桌子旁边(距离 0.4m) |
| 2 | detect | 确认水杯位置 |
| 3 | reach | 手臂伸向杯子 |
| 4 | grasp | 手指闭合抓住杯子(力 2-3N) |
| 5 | lift | 平稳抬起(慢速,不洒水) |
| 6 | navigate | 走到用户面前(距离 0.5m) |
| 7 | hand_over | 手臂伸出等待用户接住 |
| 8 | detect_grip | 确认用户已握住杯子 |
| 9 | release | 松手 |
还要处理意外情况:
- 走到桌旁发现杯子被移走了 → 重新检测
- 抓取失败(手滑了)→ 调整抓取点再试
- 走路时前方有障碍 → 绕路
- 递杯子时用户没伸手 → 等待或语音提醒
使用技术:LLM 做规划(ReAct、Chain-of-Thought)或传统规划器(PDDL)。LLM 的优势是能用常识推理处理从未遇到过的意外。
第 4 层:运动规划——算出每个关节怎么转
职责:计算从当前姿态到目标姿态的具体轨迹。
计算过程:
-
1.逆运动学(IK):目标位置 → 每个关节转多少度
text(0.42, 0.15, 0.08) → [肩关节 45°, 肘关节 90°, 腕关节 15°, ...](0.42, 0.15, 0.08) → [肩关节 45°, 肘关节 90°, 腕关节 15°, ...] -
2.碰撞检测:轨迹会不会撞到桌子?
-
3.时间参数化:每个关节的速度和加速度限制
-
4.动力学验证:力矩不超过电机限制
输出:未来 0.5 秒每 10ms 一个关节角度值的序列。
使用技术:传统规划器(MoveIt/OMPL)或 VLA 模型直接输出轨迹。
第 5 层:底层控制——.onnx 策略的主场
职责:把上层给的目标关节角度执行到位。
输入:61 维观测向量
text
├── 当前关节角度(编码器)          15D
├── 当前关节角速度                  15D
├── 身体姿态(重力投影)            3D
├── 身体角速度                      3D
├── 上一步动作                      15D
├── 相位信号 [cos(2πφ), sin(2πφ)]   2D
├── 头部命令(零填充)              4D
├── 身体命令(零填充)              6D
└── 扭转命令                        3D
├── 当前关节角度(编码器)          15D
├── 当前关节角速度                  15D
├── 身体姿态(重力投影)            3D
├── 身体角速度                      3D
├── 上一步动作                      15D
├── 相位信号 [cos(2πφ), sin(2πφ)]   2D
├── 头部命令(零填充)              4D
├── 身体命令(零填充)              6D
└── 扭转命令                        3D
输出:15 维关节转矩指令
推理频率:50-1000 Hz(实时控制)
.onnx 策略解决的是"怎么动得稳"——保持平衡、抵抗干扰、平滑控制、安全约束。它不管"往哪动",那是上面几层的事。
第 6 层:安全兜底——硬件级的最后一道防线
最底层是传统的 PID 控制器和硬件安全限制,零延迟响应:
| 安全机制 | 说明 |
|---|---|
| 力矩限制 | 任何关节的输出力矩不超过安全阈值 |
| 碰撞检测 | 检测到意外碰撞立刻停止 |
| 温度保护 | 电机过热自动降功率 |
| 紧急停止 | 检测到异常状态立刻锁死所有关节 |
这一层不依赖任何 AI 模型,是纯硬件级的安全保障。
八、六层如何协同工作
一个完整的"递水"过程,六层的工作时序:
text
0.0 秒    用户说"把水递给我"
0.5 秒    语言理解层输出任务描述
0.8 秒    视觉感知层检测到水杯位置
1.0 秒    任务规划层生成 9 步子任务序列
1.5 秒    运动规划层计算第一段轨迹(走到桌旁)
1.5-8.0s  底层控制层执行走路,每 20ms 推理一次
8.0 秒    到达桌旁,视觉层重新检测杯子位置
8.5 秒    运动规划层计算伸手轨迹
8.5-10s   底层控制层执行伸手动作
10.0 秒   抓取,触觉传感器检测握力
10.5 秒   平稳抬起杯子
10.5-18s  走到用户面前
18-20 秒  伸出杯子,等待用户接住
20.0 秒   用户握住,松手
0.0 秒    用户说"把水递给我"
0.5 秒    语言理解层输出任务描述
0.8 秒    视觉感知层检测到水杯位置
1.0 秒    任务规划层生成 9 步子任务序列
1.5 秒    运动规划层计算第一段轨迹(走到桌旁)
1.5-8.0s  底层控制层执行走路,每 20ms 推理一次
8.0 秒    到达桌旁,视觉层重新检测杯子位置
8.5 秒    运动规划层计算伸手轨迹
8.5-10s   底层控制层执行伸手动作
10.0 秒   抓取,触觉传感器检测握力
10.5 秒   平稳抬起杯子
10.5-18s  走到用户面前
18-20 秒  伸出杯子,等待用户接住
20.0 秒   用户握住,松手
整个过程约 20 秒,每一层各司其职,缺一不可。
九、VLA 模型:试图一步到位的新方向
当前最前沿的研究方向是 **VLA(Vision-Language-Action)**模型,试图把第二到第五层合并成一个模型。
text
传统方式(5 层):
  语言理解 → 视觉感知 → 任务规划 → 运动规划 → 底层控制
  每层一个模型,层间传递信息有损耗

VLA 方式(端到端):
  摄像头图像 + "把水递给我" → VLA 模型 → 关节角度
  一个模型搞定所有事
传统方式(5 层):
  语言理解 → 视觉感知 → 任务规划 → 运动规划 → 底层控制
  每层一个模型,层间传递信息有损耗

VLA 方式(端到端):
  摄像头图像 + "把水递给我" → VLA 模型 → 关节角度
  一个模型搞定所有事
代表模型
| 模型 | 机构 | 特点 |
|---|---|---|
| RT-2 | Google DeepMind | 视觉+语言→动作,频率~5Hz |
| π₀ | Physical Intelligence | 流匹配模型,连续动作,50Hz |
| OpenVLA | Stanford | 开源,70 亿参数 |
| SmolVLA | Hugging Face | 5 亿参数轻量版,Jetson 可跑 |
VLA 面临的四大挑战
| 挑战 | 说明 |
|---|---|
| 数据不够 | LLM 有互联网语料,机器人没有"动作互联网"。真机数据采集又慢又贵,一天最多几百条轨迹 |
| 推理太慢 | 大模型推理一次几百毫秒,机器人控制需要 20ms,差一个数量级 |
| 安全性不足 | LLM 说错话最多聊天翻车,VLA 做错动作可能伤人或损坏设备 |
| 泛化不足 | 换个杯子形状可能就不行,没有足够数据,泛化能力远不如 LLM |
所以当前实际部署的机器人用的都是混合方案:
text
大语言模型 + 视觉模型  负责"想"    → 云端,慢但聪明
传统规划器 / VLA       负责"计划"  → 边缘,中速
.onnx 策略            负责"动"    → 本地,快且可靠
PID + 安全系统        负责"保命"  → 硬件级,零延迟
大语言模型 + 视觉模型  负责"想"    → 云端,慢但聪明
传统规划器 / VLA       负责"计划"  → 边缘,中速
.onnx 策略            负责"动"    → 本地,快且可靠
PID + 安全系统        负责"保命"  → 硬件级,零延迟
十、Safetensors vs ONNX:存储格式之争
2025-2026 年,具身智能领域的模型格式出现了一个新趋势:Safetensors 正在取代传统的 .pth/.bin 成为模型存储和分享的标准格式。
Safetensors 由 Hugging Face 推出,核心优势是安全性(杜绝代码注入风险)和加载速度(支持零拷贝和内存映射)。
但这不意味着 ONNX 被取代了。两者服务于不同的环节:
| 格式 | 用途 | 特点 |
|---|---|---|
| Safetensors | 训练存储和模型分享 | 安全、加载快、HuggingFace 生态标准 |
| ONNX | 跨平台部署 | 一次导出,C++/Rust/Java 都能运行 |
| TensorRT .engine | NVIDIA GPU 极致性能 | 推理最快,NVIDIA 生态专用 |
不是二选一,而是各司其职。 NVIDIA 生态的主流路径是:PyTorch 训练 → SafeTensors 存储 → TensorRT-LLM 转换 → Jetson 上推理。
十一、总结
text
.onnx 策略模型 = 机器人的"肌肉"(底层控制,高频实时)
LLM            = 机器人的"语言脑"(理解指令,低频但智能)
VLM            = 机器人的"视觉脑"(看懂世界,中频)
VLA            = 机器人的"决策脑"(规划动作,中频)
世界模型        = 机器人的"想象力"(预测后果,辅助规划)
PID + 安全      = 机器人的"脊髓反射"(硬件级保命,零延迟)
.onnx 策略模型 = 机器人的"肌肉"(底层控制,高频实时)
LLM            = 机器人的"语言脑"(理解指令,低频但智能)
VLM            = 机器人的"视觉脑"(看懂世界,中频)
VLA            = 机器人的"决策脑"(规划动作,中频)
世界模型        = 机器人的"想象力"(预测后果,辅助规划)
PID + 安全      = 机器人的"脊髓反射"(硬件级保命,零延迟)
回到最初的问题:一个 .onnx 文件能让机器人把水递给你吗?
不能。 但没有它,前面所有层都是纸上谈兵。
当前行业的发展路径是:先把每个动作的 .onnx 策略训练好(走路、踢球、抓取、平衡恢复),建立完整的技能库。然后用高层的大语言模型和视觉模型去编排这些技能,完成复杂任务。先练好"肌肉",再发展"大脑"。
VLA 模型是未来可能的统一方案,但目前还不成熟。混合架构是当下最务实的选择。
最终的目标是:机器人能听懂人话、看懂世界、自主规划、灵活行动。从 .onnx 到 AGI,这条路很长,但每一步都在向前。
作者注:本文以 MicroDuck 双足机器人为实际案例,结合具身智能领域的最新技术进展,尝试梳理从底层控制到高层决策的完整技术链路。文中提到的技术栈和架构方案反映了 2025-2026 年具身智能领域的主流实践。